Biotecnología moderna: principales técnicas de secuenciación genómica y sus aplicaciones
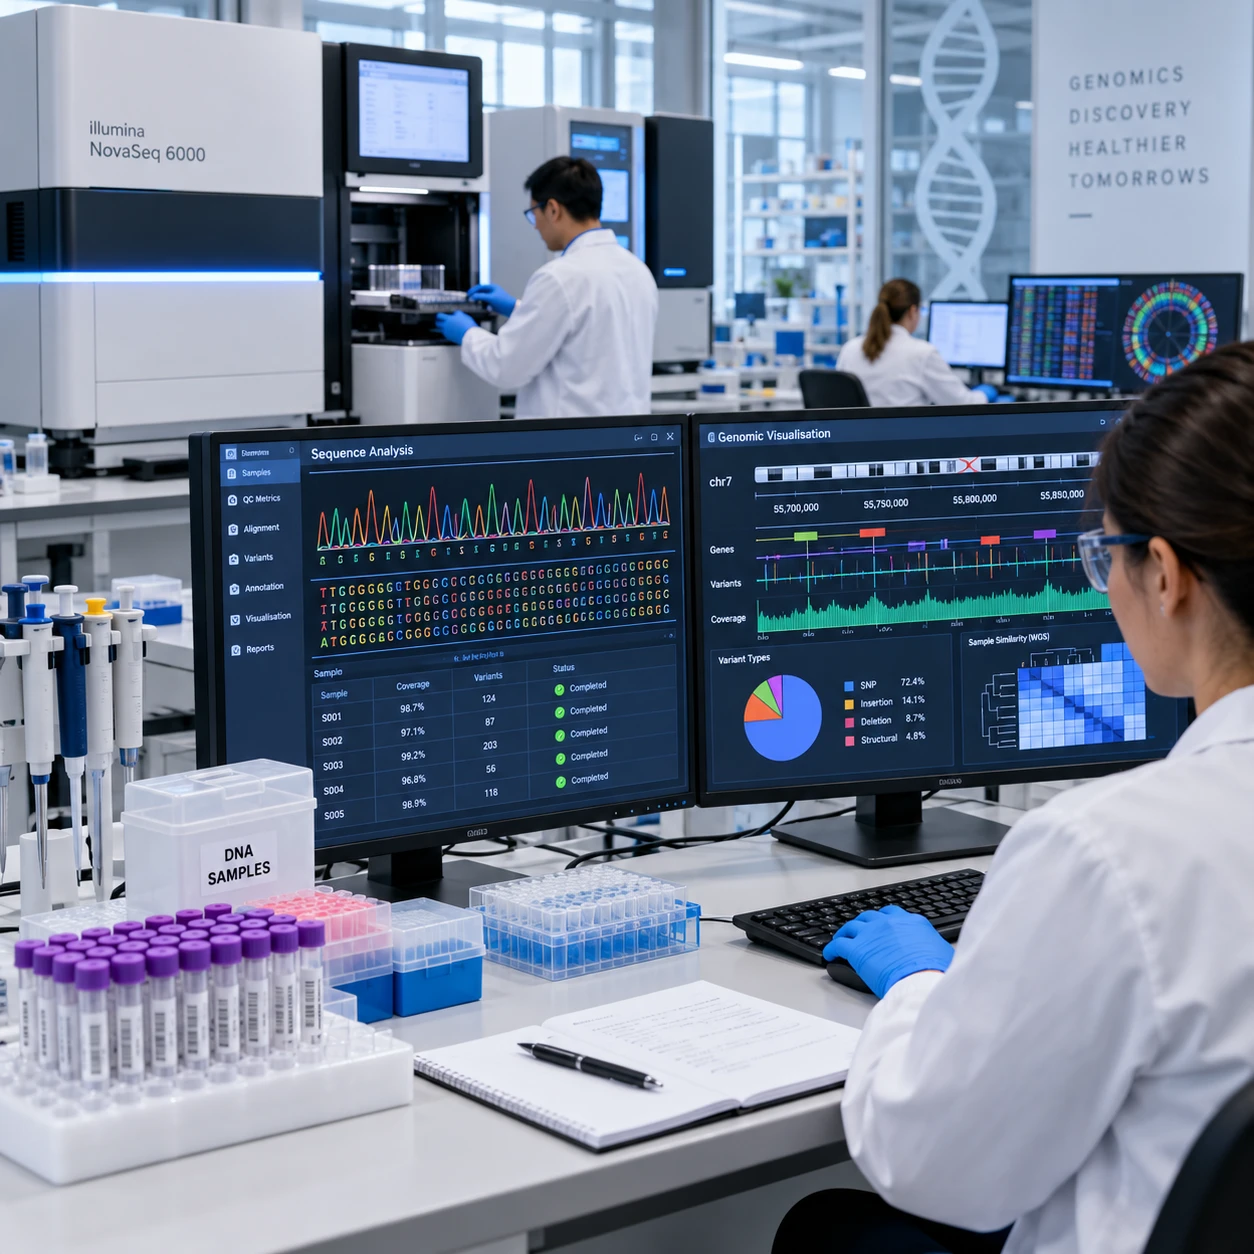
La secuenciación genómica permite leer el orden de las bases del ADN para estudiar genes, variación genética y características de una muestra. En la biotecnología moderna, distintas técnicas ofrecen maneras complementarias de obtener esa información: la elección depende de la pregunta científica, el material disponible y el tipo de variantes que se busca detectar.
Qué es la secuenciación genómica y qué información aporta
La secuenciación genómica determina el orden de las bases del ADN de una región o de un genoma y ayuda a identificar diferencias respecto a una secuencia de referencia. El resultado puede revelar variantes genéticas, aunque su interpretación depende del diseño del estudio y del análisis posterior.
El alcance varía según la estrategia. La secuenciación del genoma completo examina regiones codificantes y no codificantes; la secuenciación de exoma se centra en las partes de los genes que codifican proteínas, conocidas como exones. También pueden secuenciarse genes o regiones seleccionados cuando la hipótesis ya está delimitada.
Los datos pueden incluir sustituciones de una base, pequeñas inserciones o deleciones y, según la técnica y el análisis, cambios estructurales o variaciones en el número de copias. Secuenciar no equivale a editar el ADN ni determina por sí solo la función de una variante. La evidencia biológica, la calidad de los datos y el contexto de la muestra son esenciales para interpretarla.
De Sanger a la secuenciación de nueva generación
La diferencia principal es que la secuenciación Sanger analiza fragmentos de ADN de forma dirigida, mientras que la secuenciación de nueva generación (NGS) permite leer grandes cantidades de fragmentos en paralelo. Ambas siguen siendo útiles: la mejor opción depende del tamaño del análisis y de la pregunta.
Sanger fue durante años el método de referencia para secuenciar fragmentos específicos y todavía sirve para estudiar una región concreta o confirmar resultados seleccionados, si el diseño y los criterios del laboratorio lo justifican. Su enfoque dirigido puede ser práctico cuando hay pocas regiones de interés, pero analizar muchos genes de esta manera puede requerir más trabajo individual.
NGS agrupa numerosas lecturas en una misma corrida y puede aplicarse a paneles de genes, exomas o genomas completos. Esta capacidad amplía el volumen de datos, pero también exige una preparación de bibliotecas adecuada, controles y análisis bioinformático especializado. NGS no es una técnica única: incluye plataformas y estrategias distintas, entre ellas la secuenciación de lectura corta y la de lectura larga.
Lecturas cortas y lecturas largas: diferencias clave
Las lecturas cortas cubren fragmentos pequeños de ADN con gran capacidad para procesar muchos datos en paralelo; las lecturas largas abarcan tramos mayores y pueden ayudar a resolver regiones complejas. Ninguna modalidad detecta de forma óptima todos los tipos de variación, por lo que la comparación debe considerar el objetivo y el genoma analizado.
En la secuenciación de lectura corta, las lecturas se alinean con una referencia para reconstruir la secuencia. Suele ser adecuada para identificar sustituciones y variantes pequeñas en regiones bien representadas. Sin embargo, regiones repetitivas o segmentos muy similares entre sí pueden dificultar la asignación de cada lectura y complicar la detección de algunos cambios estructurales.
La secuenciación de lectura larga puede abarcar regiones repetitivas, conectar variantes distantes y facilitar el estudio de reordenamientos o ciertas variantes estructurales. Sus limitaciones dependen de la plataforma, la preparación y el análisis; además, no siempre es la opción más práctica para cada proyecto. En ocasiones, combinar lecturas cortas y largas permite aprovechar la cobertura de unas y el contexto amplio de las otras.
- Pregunta sobre variantes pequeñas en regiones definidas: considere un panel o una estrategia de lectura corta.
- Pregunta sobre regiones repetitivas o cambios estructurales: valore lecturas largas y confirme qué tipos de variantes puede analizar el servicio.
- Pregunta amplia o de descubrimiento: compare exoma y genoma completo según las regiones de interés y los recursos de interpretación disponibles.
Etapas de un flujo de trabajo de secuenciación
Un flujo de trabajo de secuenciación comprende la selección y el control de calidad de la muestra, la preparación de bibliotecas, la lectura del ADN y el análisis bioinformático. Cada etapa influye en la utilidad de los datos, así que conviene definir desde el inicio qué resultado necesita el estudio.
Primero se escoge el tipo de muestra y se revisan su identidad, cantidad e integridad. Los requisitos varían según el material y el método; por eso el laboratorio debe indicar cómo recolectar, conservar y enviar la muestra. Una muestra degradada o contaminada puede limitar el análisis, incluso si la plataforma de secuenciación es adecuada.
Durante la preparación de bibliotecas, el ADN se procesa para que la plataforma pueda leerlo. El protocolo puede incluir fragmentación, incorporación de adaptadores y, en determinados métodos, selección o enriquecimiento de regiones. Después, la secuenciación genera lecturas que pasan por controles y procesos de análisis bioinformático, como alineación con una referencia, identificación de variantes y filtros de calidad.
Antes de contratar un análisis, pregunte qué controles se aplican, cómo se gestionan las muestras con calidad insuficiente y qué productos se entregan: lecturas, variantes filtradas, informe o datos adicionales. Un archivo de datos no equivale a una interpretación biológica completa.
Aplicaciones en investigación y servicios de laboratorio
La secuenciación genómica se utiliza para caracterizar muestras, estudiar diversidad genética y buscar variantes relacionadas con una pregunta de investigación. En los servicios de laboratorio, la estrategia y el alcance del informe deben ajustarse al tipo de muestra, al objetivo y al uso previsto de los resultados.
En investigación, la secuenciación puede apoyar estudios de expresión y regulación cuando se combina con diseños específicos, comparar poblaciones o analizar cambios en modelos experimentales. En microbiología y vigilancia, puede contribuir a caracterizar organismos y explorar relaciones entre muestras, siempre que el protocolo y los datos sean adecuados para ese propósito.
En análisis de variantes, paneles dirigidos, exoma y genoma completo responden a preguntas distintas. Un panel puede concentrar el análisis en genes seleccionados; el exoma examina regiones codificantes, y el genoma completo ofrece un alcance más amplio, aunque genera más datos que también deben almacenarse, filtrarse e interpretarse. En aplicaciones clínicas, la secuenciación requiere validación y revisión profesional conforme al contexto regulatorio y asistencial. Un resultado de investigación no debe presentarse automáticamente como diagnóstico.
Cómo elegir una técnica de secuenciación
Para elegir una técnica de secuenciación, defina primero qué pregunta quiere responder, qué tipo de muestra tiene y qué variantes necesita detectar. Después compare el alcance, los requisitos de calidad, el método de análisis y el formato de entrega del laboratorio.
Puede ordenar la decisión con cuatro preguntas: qué región se estudiará, qué variante interesa, en qué estado está la muestra y qué resultado necesita recibir. Si busca cambios conocidos en pocas regiones, una estrategia dirigida puede ser suficiente. Para una exploración más amplia, valore exoma o genoma completo; si sospecha variantes estructurales o regiones repetitivas, pregunte si las lecturas largas aportan una ventaja concreta.
Antes de seleccionar un servicio, revise estos puntos:
- Especies, tipos de muestra y cantidades aceptadas, además de instrucciones de envío y conservación.
- Regiones cubiertas, tipos de variantes evaluadas y límites declarados del método.
- Controles de calidad y criterios para aceptar, repetir o rechazar una muestra.
- Alcance del análisis bioinformático, referencia utilizada y formato de los archivos entregados.
- Si el informe es descriptivo, de investigación o validado para el uso clínico previsto.
La decisión más útil no siempre es escoger la plataforma más amplia. Un análisis más extenso puede generar datos que no responden a la pregunta inicial o que requieren recursos adicionales de interpretación. Alinear muestra, método y objetivo desde el principio reduce esa brecha.
Preguntas frecuentes
¿Cuál es la diferencia entre secuenciación Sanger y NGS? Sanger analiza fragmentos concretos de forma dirigida; NGS lee muchos fragmentos en paralelo y facilita estudios más amplios, como paneles, exoma o genoma completo.
¿Qué distingue las lecturas cortas de las lecturas largas? Las cortas abarcan fragmentos menores y son útiles para muchas variantes pequeñas; las largas aportan más contexto por lectura y pueden facilitar el análisis de regiones repetitivas y cambios estructurales. La idoneidad depende de la plataforma y del objetivo.
¿Qué muestras pueden analizarse mediante secuenciación genómica? Se pueden analizar distintos materiales biológicos que contengan ADN, como sangre, saliva, tejidos o microorganismos. La aceptación depende del método, la calidad, la cantidad y los requisitos del laboratorio.
¿Por qué es importante el análisis bioinformático? Porque convierte las lecturas en resultados interpretables: evalúa su calidad, las compara con una referencia y ayuda a identificar y filtrar variantes. Sin este paso, los datos de secuenciación no responden por sí solos a la pregunta del estudio.